Detección de objetos MobileNet SSD mediante el módulo OpenCV 3.4.1 DNN
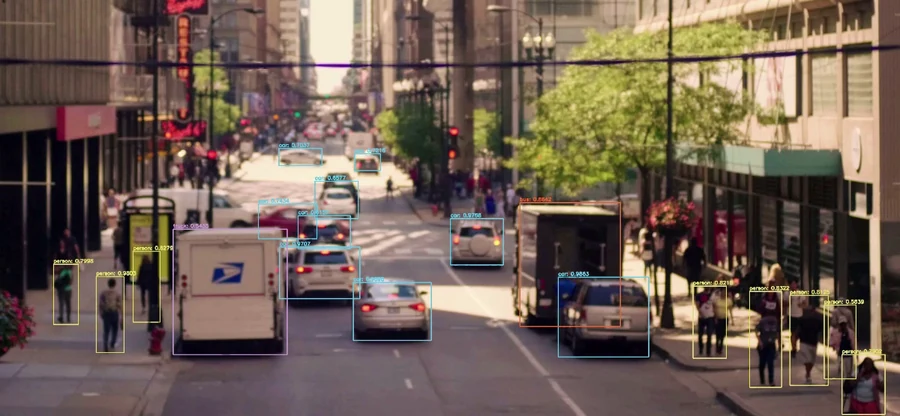
Detección de objetos MobileNet SSD usando el módulo OpenCV 3.4.1 DNN
Esta publicación demuestra cómo usar el módulo de aprendizaje profundo OpenCV 3.4.1 con la red MobileNet-SSD para el descubrimiento de objetos.
Como parte de Opencv 3.4. + Se incluyó oficialmente el módulo de red neuronal profunda (DNN). El módulo DNN permite cargar modelos previamente entrenados de los marcos de aprendizaje profundo más populares, incluidos Tensorflow, Caffe, Darknet, Torch. Además de MobileNet-SDD, otras arquitecturas son compatibles con OpenCV 3.4.1:
GoogleLeNet YOLO SqueezeNet R-CNN más rápido ResNet Esta API es compatible con C ++ y Python. : -) Código de descripción
En esta sección, crearemos el script Python para la detección de objetos y explicaremos, ¿cómo cargar nuestra red neuronal profunda con OpenCV 3.4? ¿Cómo pasar la imagen a la red neuronal? y ¿Cómo hacer una predicción con MobileNet o módulo dnn en OpenCV ?.
Usamos un MobileNet previamente entrenado tomado dehttps://github.com/chuanqi30 5 / MobileNet-SSD / que se entrenó en el marco Caffe-SSD. Este modelo puede detectar 2 clases.
Cargue y prediga con el módulo de red neuronal profunda
Primero creamos un nuevo archivo Python mobilenet_ssd_python.py ponemos el siguiente código, aquí importamos las librerías:
Copy to Clipboard Syntax Highlighter 1 #Import the neccesary libraries 2 import numpy as np 3 import argparse 4 import cv2 5 6 #Next, add the parser command lines: 7 8 # construct the argument parse 9 parser = argparse.ArgumentParser( 10 description='Script to run MobileNet-SSD object detection network ') 11 parser.add_argument("--video", help="path to video file. If empty, camera's stream will be used") 12 parser.add_argument("--prototxt", default="MobileNetSSD_deploy.prototxt", 13 help='Path to text network file: ' 14 'MobileNetSSD_deploy.prototxt for Caffe model or ' 15 ) 16 parser.add_argument("--weights", default="MobileNetSSD_deploy.caffemodel", 17 help='Path to weights: ' 18 'MobileNetSSD_deploy.caffemodel for Caffe model or ' 19 ) 20 parser.add_argument("--thr", default=0.2, type=float, help="confidence threshold to filter out weak detections") 21 args = parser.parse_args() 22
La línea anterior establece los siguientes argumentos:
Video: archivo de ruta de video. Prototxt: el archivo de red es .prototxt Pesos: el archivo de ponderaciones de red es .caffemodel Thr: umbral de confianza.
A continuación, definimos las etiquetas para las clases en nuestra red MobileNet-SSD.
Copy to Clipboard Syntax Highlighter 1 #Labels of network. 2 classNames = { 0: 'background', 3 1: 'aeroplane', 2: 'bicycle', 3: 'bird', 4: 'boat', 4 5: 'bottle', 6: 'bus', 7: 'car', 8: 'cat', 9: 'chair', 5 10: 'cow', 11: 'diningtable', 12: 'dog', 13: 'horse', 6 14: 'motorbike', 15: 'person', 16: 'pottedplant', 7 17: 'sheep', 18: 'sofa', 19: 'train', 20: 'tvmonitor' }
A continuación, abrimos el archivo de video o dispositivo de captura según lo que elijamos, también cargamos el modelo modelo Caffe.
Copy to Clipboard Syntax Highlighter 1 # Next, open the video file or capture device depending what we choose, also load the model Caffe model. 2 # Open video file or capture device. 3 if args.video: 4 cap = cv2.VideoCapture(args.video) 5 else: 6 cap = cv2.VideoCapture(0) 7 8 #Load the Caffe model 9 net = cv2.dnn.readNetFromCaffe(args.prototxt, args.weights)
En la línea 36, pasa el prototxt y los argumentos de ponderación a la función, luego cargamos correctamente la red.
Luego leemos el video cuadro por cuadro y lo pasamos en el cuadro a la web para su detección. Con el módulo DNN es fácil usar nuestra red de aprendizaje profundo en OpenCV y hacer predicciones.
Copy to Clipboard Syntax Highlighter 1 while True: 2 # Capture frame-by-frame 3 ret, frame = cap.read() 4 frame_resized = cv2.resize(frame,(300,300)) # resize frame for prediction
En la línea 40 -41, lea el fotograma del video y cambie el tamaño a 300 × 300 porque es el tamaño de entrada de imagen definido para el modelo MobileNet-SSD.
Copy to Clipboard Syntax Highlighter 1 # MobileNet requires fixed dimensions for input image(s) 2 # so we have to ensure that it is resized to 300x300 pixels. 3 # set a scale factor to image because network the objects has differents size. 4 # We perform a mean subtraction (127.5, 127.5, 127.5) to normalize the input; 5 # after executing this command our "blob" now has the shape: 6 # (1, 3, 300, 300) 7 blob = cv2.dnn.blobFromImage(frame_resized, 0.007843, (300, 300), (127.5, 127.5, 127.5), False) 8 #Set to network the input blob 9 net.setInput(blob) 10 #Prediction of network 11 detections = net.forward()
Después de las líneas anteriores, obtenemos la predicción de la red, simplemente haciéndolo en tres pasos básicos:
Subir una imagen Preprocesar la imagen Establezca la imagen como entrada de red y obtenga el resultado de la predicción.
El uso del módulo DNN es esencialmente el mismo para las otras redes y arquitecturas, por lo que podemos replicarlo para nuestros propios modelos entrenados.
Visualice la confianza en la detección y predicción de objetos
En conclusión, después de los pasos anteriores, surgen nuevas preguntas, ¿Cómo obtener la ubicación del objeto con MobileNet? ¿Cómo saber la clase de objeto predicha? ¿Cómo tener confianza en la predicción? ¡Ir!
Debemos leer la matriz de detección para obtener los datos de predicción de la red neuronal, el siguiente código hace esto:
Copy to Clipboard Syntax Highlighter 1 #Size of frame resize (300x300) 2 cols = frame_resized.shape[1] 3 rows = frame_resized.shape[0] 4 5 #For get the class and location of object detected, 6 # There is a fix index for class, location and confidence 7 # value in @detections array . 8 for i in range(detections.shape[2]): 9 confidence = detections[0, 0, i, 2] #Confidence of prediction 10 if confidence > args.thr: # Filter prediction 11 class_id = int(detections[0, 0, i, 1]) # Class label 12 13 # Object location 14 xLeftBottom = int(detections[0, 0, i, 3] * cols) 15 yLeftBottom = int(detections[0, 0, i, 4] * rows) 16 xRightTop = int(detections[0, 0, i, 5] * cols) 17 yRightTop = int(detections[0, 0, i, 6] * rows)
Hacemos un bucle (línea 62) para leer los valores. Luego, en la línea 63 obtenemos la confianza de la predicción y el siguiente filtro de línea con valor de umbral. En la línea 65, obtenga la etiqueta. En las líneas 68 a 71, obtenga las esquinas del objeto.
Con toda la información sobre el objeto predicho, el último paso es mostrar los resultados. El siguiente objeto de dibujo de código detectado y muestra su etiqueta y confianza en el marco.
Copy to Clipboard Syntax Highlighter 1 # Factor for scale to original size of frame 2 heightFactor = frame.shape[0]/300.0 3 widthFactor = frame.shape[1]/300.0 4 # Scale object detection to frame 5 xLeftBottom = int(widthFactor * xLeftBottom) 6 yLeftBottom = int(heightFactor * yLeftBottom) 7 xRightTop = int(widthFactor * xRightTop) 8 yRightTop = int(heightFactor * yRightTop) 9 # Draw location of object 10 cv2.rectangle(frame, (xLeftBottom, yLeftBottom), (xRightTop, yRightTop), 11 (0, 255, 0)) 12 13 # Draw label and confidence of prediction in frame resized 14 if class_id in classNames: 15 label = classNames[class_id] + ": " + str(confidence) 16 labelSize, baseLine = cv2.getTextSize(label, cv2.FONT_HERSHEY_SIMPLEX, 0.5, 1) 17 18 yLeftBottom = max(yLeftBottom, labelSize[1]) 19 cv2.rectangle(frame, (xLeftBottom, yLeftBottom - labelSize[1]), 20 (xLeftBottom + labelSize[0], yLeftBottom + baseLine), 21 (255, 255, 255), cv2.FILLED) 22 cv2.putText(frame, label, (xLeftBottom, yLeftBottom), 23 cv2.FONT_HERSHEY_SIMPLEX, 0.5, (0, 0, 0)) 24 25 print label #print class and confidence 26 27 cv2.namedWindow("frame", cv2.WINDOW_NORMAL) 28 cv2.imshow("frame", frame) 29 if cv2.waitKey(1) >= 0: # Break with ESC 30 break
Últimas líneas, muestra la imagen del marco normal y cambia el tamaño a la pantalla.
Descargas
El código y el modelo capacitados por MobileNet se pueden descargar desde:
https://github.com/djmv/MobilNet_SSD_opencv